 SurgePix Docs
Vibecoding 还没学会?没关系! 用 GPT-Image-2,“Vibe Design”你压根不用学
一觉醒来,你的朋友圈和社交平台是不是也被一群“假照片”给占领了?
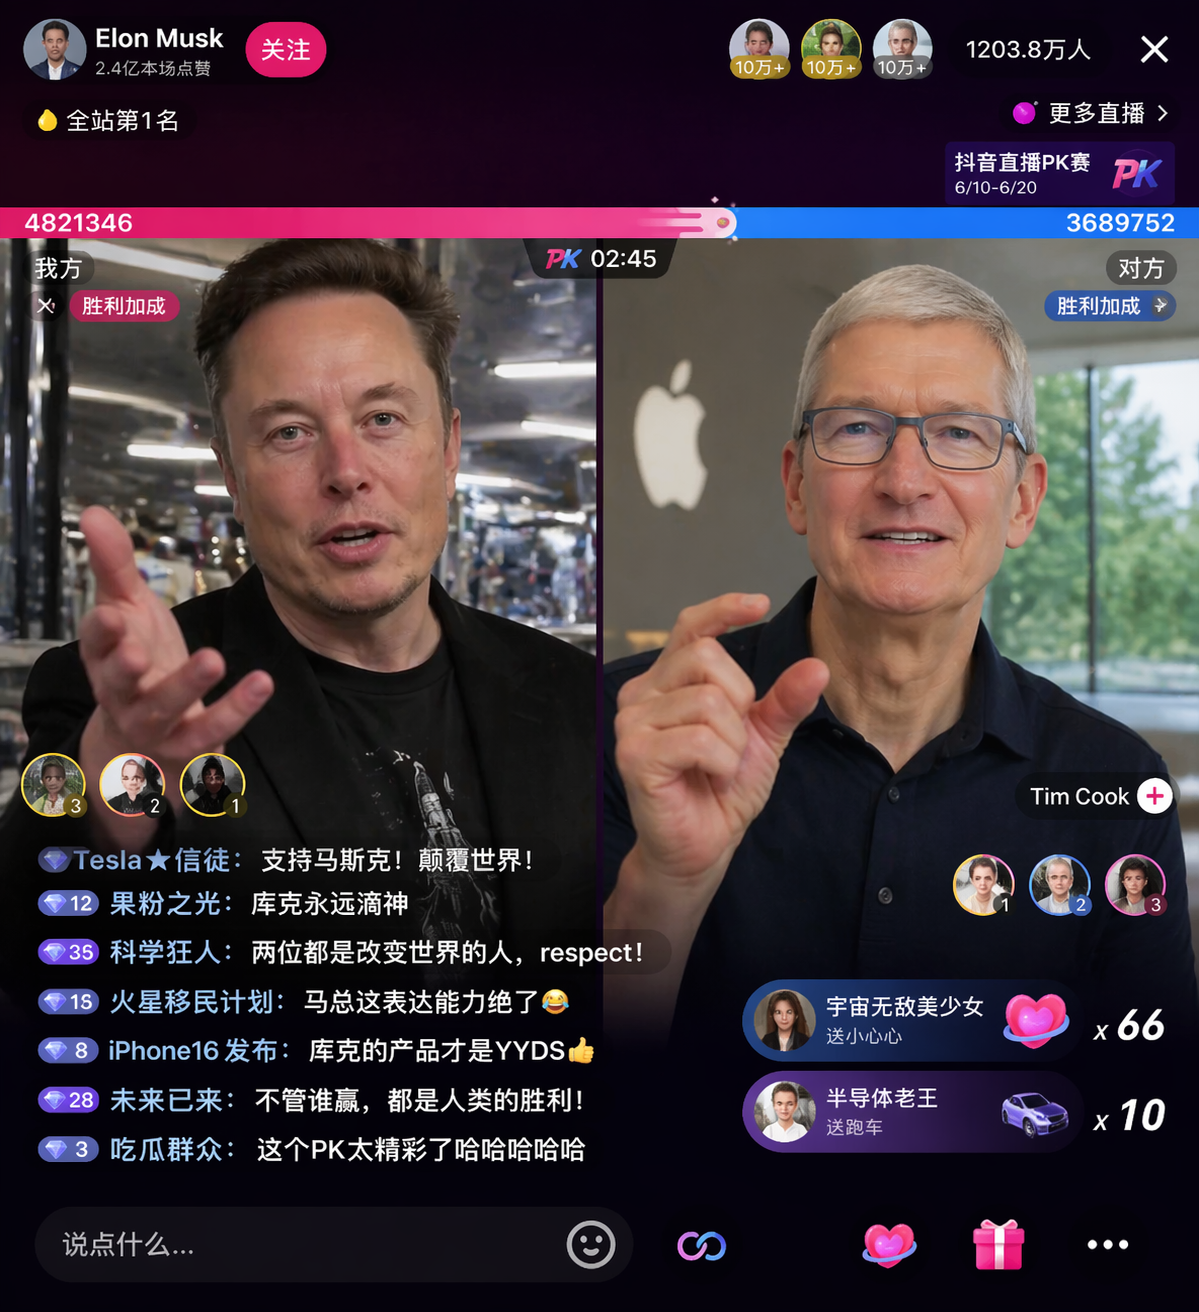
从马斯克和库克连麦打 PK 的直播截图,到像素级复刻的《兰亭集序》真迹,再到极其地道的日式餐厅菜单……这种“一眼真”的冲击力,源于 2026 年 4 月 22 日凌晨的一场直播后,GPT-Image-2 正式全量上线。网友们惊呼:“有图有真相”的时代彻底终结了,因为你根本分不清那是相机拍的,还是 AI 编的。
除了社交媒体的梗图让人看不过来,Text-to-Image 竞技场排行榜也同步公布:GPT-Image-2 以 1512 的超高分直接空降榜首,领先第二名(自带联网搜索的 Nano-banana-2)整整 242 分。在以往分数紧咬的竞技场历史上,这种“代差级”的碾压是绝无仅有的。事实上,这个模型在世界知识、审美质感、以及那种近乎变态的微观控制力上,展现出了真正的降维打击。
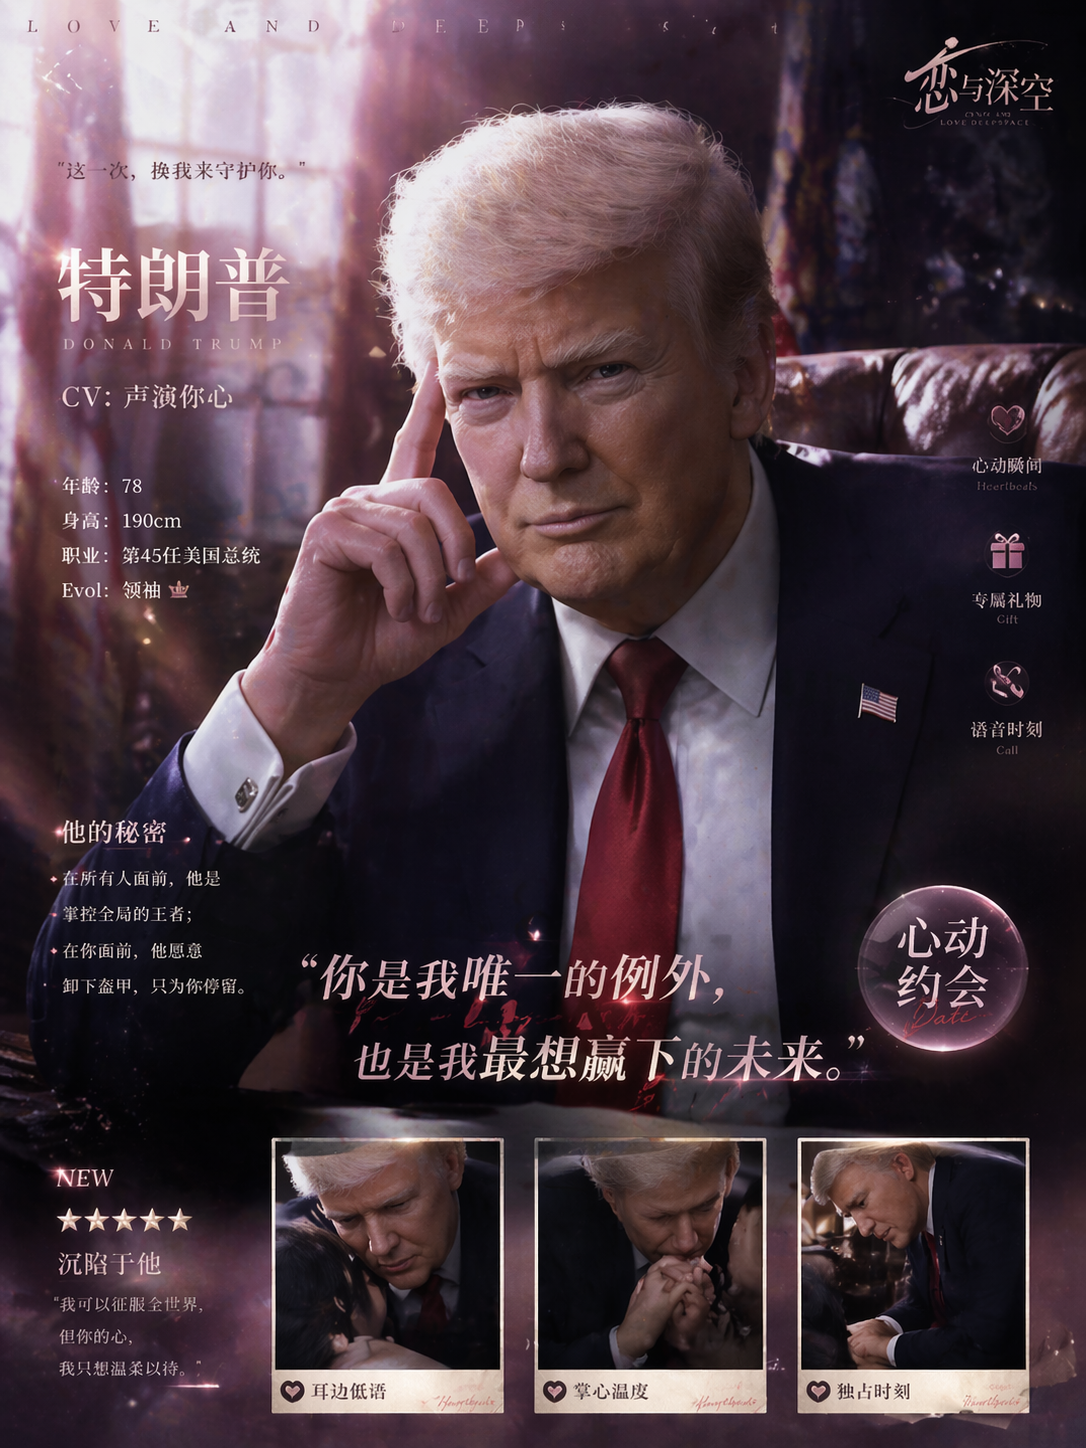
01 它是真的懂世界,而你是真的分不清
GPT-Image-2 最离谱的地方不在于它“画得像”,而在于它拥有恐怖的“世界知识”。
世界知识的意思,就是这个模型对真实世界长什么样,有着极其精准的理解。
过去对于AI生成的图像,大部分还是能分辨出来的。比如ai感太强的人物、ip,又或者是超现实主义的场景都会轻易的被甄别为#AI生成内容。
而对于今天的GPT-Image-2,当你让它生成一张 YouTube、小红书或 B 站的截图时,它不再是乱涂一个图标,而是能画出精准的布局、正确的按钮位置,甚至连封面图和点赞数都符合逻辑。
在测试“马斯克抖音直播”时,它不仅画出了人像,还自主脑补了左上角的关注按钮、右上角的千万级在线人数、甚至底部标明了划线价和特价的商品卡片。最让人头皮发麻的是,它还编出了极其真实的网友弹幕,比如“支持马斯克!”。这说明它不仅懂画画,还懂中国的互联网梗和商业运营逻辑。
02 “思考模式”上线:解释了它为什么比过往的AI生图模型精准
这种“降维打击”般的精准度,全靠它内置的一个“大脑”——“思考模式”(Thinking Mode)。
跟以前那些闭着眼“抽盲盒”的模型不同,GPT-Image-2 在渲染第一个像素之前,会先进入一段 10 到 20 秒的逻辑推理阶段。
- 它会先“查资料”:它能实时访问互联网,去 Reddit、LinkedIn 或 Threads 上爬取真实的网友评价和金句,确保生成的文案不是瞎编的。
- 它会“做策略”:它很可能接入了 OpenAI 最顶尖的推理模型(如 o4 或 o3),在落笔前先算好商业逻辑、受众心理和版式坐标。
- 它会生成“活的资产”:它甚至能生成真实可扫描的二维码,直接跳转到目标网站,而不是以前那种没用的假贴图。
- PS:官方渠道的思考模式提供给付费用户使用,默认使用即时模式
03 文字渲染的“Aha!时刻”:中文不再是模糊不清的“鬼画符”
GPT-Image-2 干掉了 AI 生图最劝退普通人的那个致命通病
GPT-Image-2 干掉了 AI 生图最劝退普通人的那个致命通病
AI 生图圈一直有个 “世纪难题”:能画好图,却写不好字。从早期模型到前代旗舰,文字渲染始终是绕不开的硬伤 —— 中文乱码、英文拼写错误、笔画扭曲粘连、字体风格漂移、小字模糊成糊,这些通病让带文字的海报、UI、信息图、包装设计几乎没法直接商用,设计师只能手动修字、重排,AI 沦为 “半成品工具”。
而 GPT-Image-2 的核心突破,正是抛弃传统扩散模型的 “一步出图”,引入Thinking 推理模式,先由语言模型做 “文字规划师”:拆解提示词里的文字内容、字体、位置、排版层级,生成隐式布局草图;再激活专用文字渲染模块,按真实排版引擎逻辑(字体选择、字距调整、抗锯齿)精准渲染,让文字从 “被动像素” 变成 “主动设计元素”。
这直接打通了 AI 生图的 “最后一公里”:
- 设计师不用再手动修字、重排,海报、包装、信息图一键生成,效率提升 10 倍 +;
- 产品经理、运营人员可直接生成带精准文字的 UI 原型、电商主图、宣传物料,零设计基础也能出专业图;
- 教育、医疗、科普领域的信息图、课件、处方笺等,AI 可精准生成文字内容,内容可信度与实用性拉满。
- 此次模型的升级后,极大的提升了中文、印地语、韩语、日语等亚洲语言的生成准确性
甚至连最刁钻的“微观控制”它也拿捏了。在发布会现场进行的“米粒测试”中,它能在一堆大米中锁定一颗,并顺着米粒的自然弧度刻下清晰的文字。这种对手术刀级物理空间的掌控,意味着你以后想改图里的任何小局部,都能做到“指哪打哪”。
04 一致性的终结者:一句话生成连续剧
在此之前,几乎所有 AI 图像模型都有一个公认死穴:角色 consistency(一致性)崩坏。
同样一个人,换个角度、换个场景、换个姿势,秒变陌生脸;想做一组故事感图、分镜、人物写真合集,结果每张都是 “失散多年的兄弟姐妹”,完全没法当成同一个角色看。想做连贯剧情,只能靠海量 LoRA 训练、反复垫图、精细调参,门槛高到劝退绝大多数人。
而 GPT-Image-2,直接把这个问题彻底终结了。
它不再是 “一张一张独立画图”,而是真正理解角色、场景、剧情、时间线。你只需要一句话,描述清楚人物长相、性格、故事主线,模型就能自动保持:
- 同一张脸、同款发型、同款气质贯穿始终
- 服装、配饰、标志性特征高度统一
- 光影、色调、镜头语言连贯成系列
- 动作、场景、情绪自然递进,像剧本分镜一样顺承
不用垫图、不用训模型、不用反复校对,一句话,直接生成一整部 “视觉连续剧”。从单人写真套图、故事插画,到短视频分镜、广告剧情稿,AI 第一次实现了真正可用、可商用的视觉连续性。
对内容创作者、设计师、短剧团队来说,这意味着:以前要花几天抠一致性,现在几分钟出一套完整剧情视觉。GPT-Image-2 不只是提升画质,而是把 AI 从 “单张画师” 升级成了 “能拍连续剧的导演”。
最后:接近90分的设计,现在是全人类的“底费”
设计圈的“奥本海默时刻”毫无预兆地降临了。当文字渲染、物理精准度、角色一致性这些“技术活”都变成了免费的底层指令,“画图”这种执行层工作的成本正在归零。
- 文字渲染零错误:无论是在米粒上刻字,还是复刻《兰亭集序》,它都能做到文本清晰、零错字、零乱码。
- 叙事一致性:你可以上传一张照片,让它画三页剧情连贯的漫画,不管是特写还是远景,人物的特征、发型细节甚至衣服褶皱都能保持完美统一。
- 边际成本暴跌:新模型引入了“缓存输入”(Cached inputs),这意味着当你生成系列海报或漫画时,后续图片的输入成本直接暴跌 75%。模型越聪明,你画得越多,单张成本反而越低。
好消息是,你现在不需要等待,因为 SurgePix 已经正式接入了 GPT-Image-2 全量模型,并且完全免费开放给大家使用!不需要排队等待!
体验地址:https://surgepix.ai
另附几个Prompt示例供大家试手:
- “帮我做一张科技风海报,先去网上搜一下大家对 XXX 产品的真实评价,把最火的金句印在图上,并附上一个指向官网的真实可扫码二维码。”
- “生成一张抖音直播间截图,主角是马斯克,他正在带货 XX。记得加上真实的在线人数、商品卡片和符合氛围的网友弹幕。”
- “画一堆散落的咖啡豆,在其中一颗特定的豆子上刻出 XX 品牌 Logo。注意微距镜头的景深效果和材质纹理。”
- “基于我上传的这张合照,把我们俩变成主角,画三页剧情连贯的日式漫画。要求在不同视角(特写、远景、背影)下,我们的面部特征和服装细节保持完全一致。”
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
别再纠结真假,也别忙着焦虑,赶紧去 SurgePix 体验这个属于普通人的“外挂时刻”吧! 既然审美已经民主化了,那就让我们在思辨和创意的赛道上见。
愿与诸君共勉,开启你的 Vibe Design 之路!
在旧的执行工具链断裂的今天,重要的不再是 AI 会不会替代我们,而是我们如何适应这条全新的生产线。
如果你在体验 GPT-Image-2 的过程中有任何想法、建议,或者发现了什么好玩的“神级”指令,欢迎加入我们的Discord社群 https://discord.gg/wC5XeHN6fR参与讨论并提出意见!
你要用的模型都在这里
All In Surgepix